Un entusiasta ejecuta un modelo de IA de 2.8 billones de parámetros usando CPU y memorias Optane
Un usuario de la comunidad de laboratorios domésticos compartió una instalación capaz de ejecutar un modelo de inteligencia artificial Kimi K3 de 2.8 billones de parámetros con un procesador Xeon Scalable de 40 núcleos y memorias Intel Optane PMem 200, sin usar una GPU para la inferencia.
Compartir esta nota
Envíala por mensaje o publícala en tus redes.
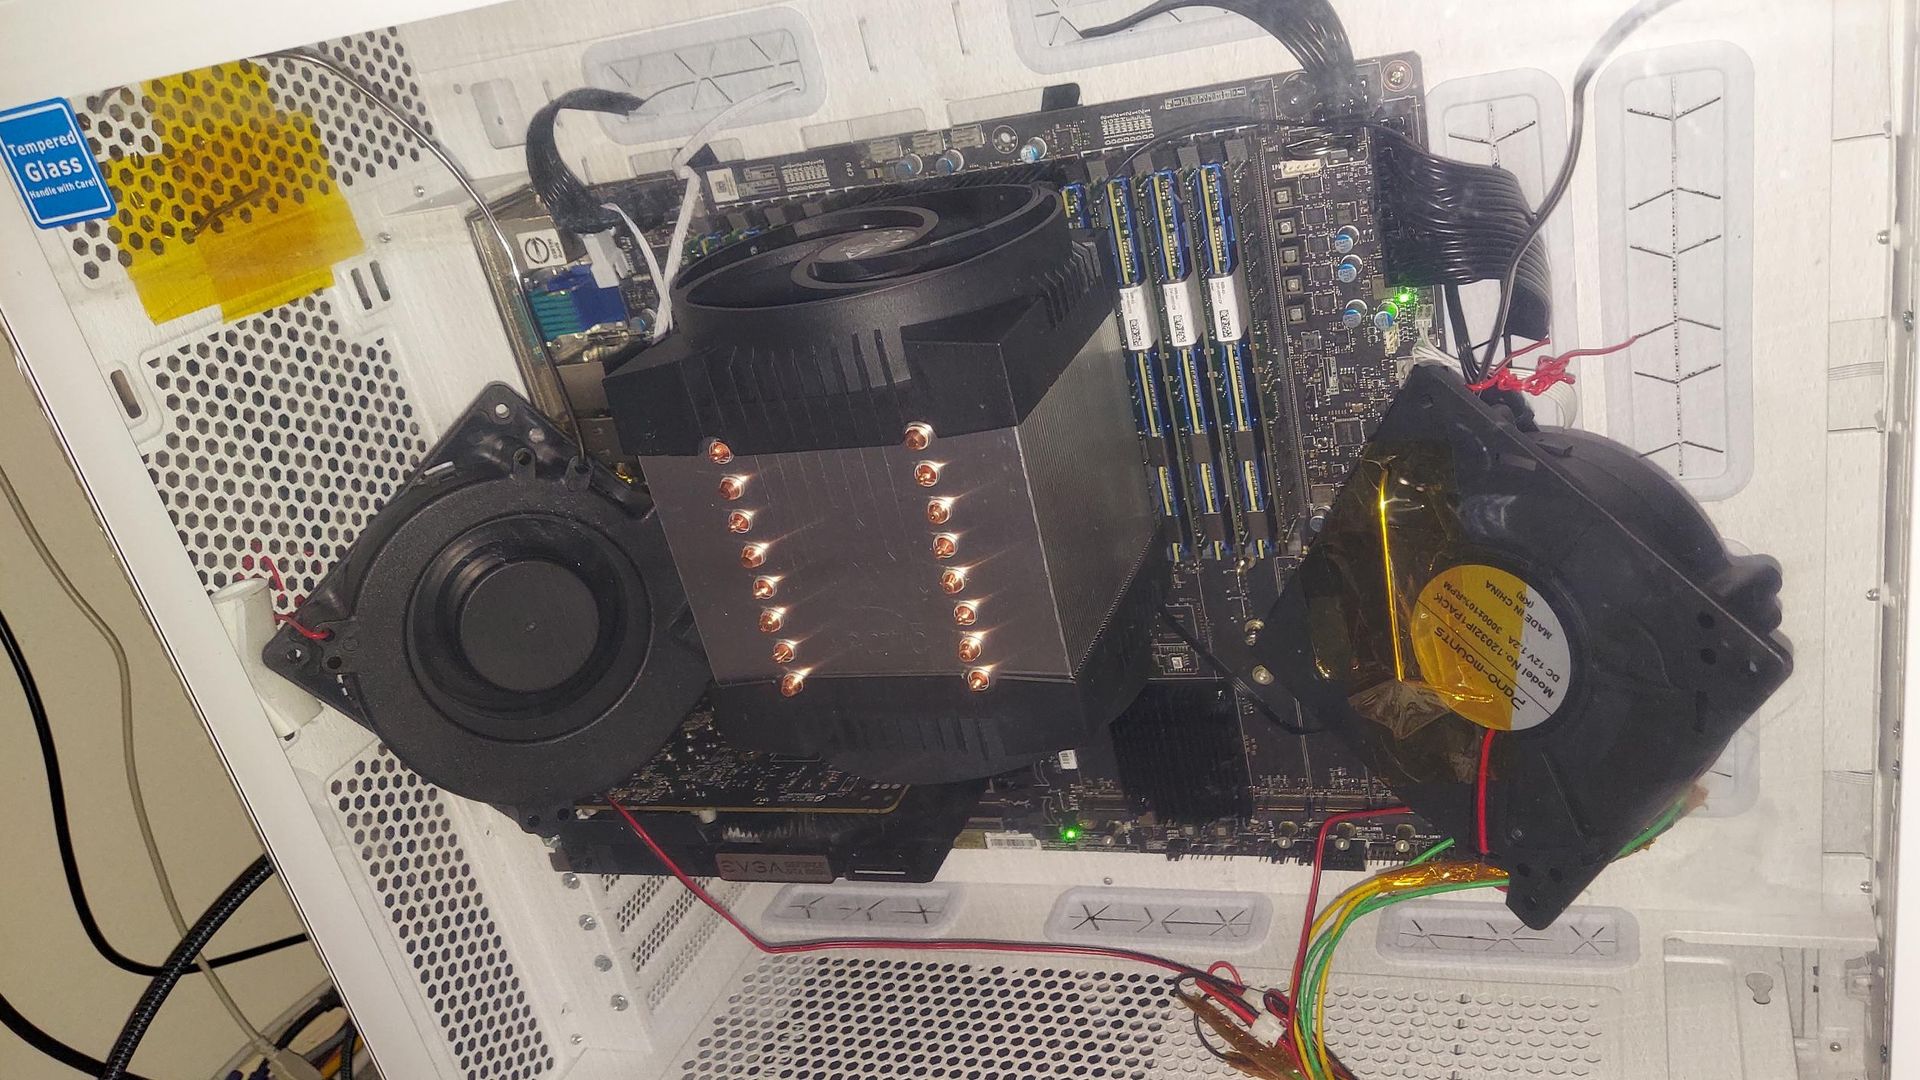
Un usuario de la comunidad de laboratorios domésticos compartió una instalación capaz de ejecutar un modelo de inteligencia artificial Kimi K3 de 2.8 billones de parámetros con un procesador Xeon Scalable de 40 núcleos y memorias Intel Optane PMem 200, sin usar una GPU para la inferencia.
Detalles y contexto
El experimento utiliza una cuantización extrema para reducir los requisitos de almacenamiento y demuestra posibilidades de hardware de servidor reutilizado. Sin embargo, la velocidad reportada es aproximadamente 0.85 tokens por segundo, muy por debajo de una experiencia conversacional rápida. También necesitó ventilación activa dirigida a los módulos de memoria para contener las temperaturas.
Qué conviene tener en cuenta
Es una prueba experimental comunitaria, no una recomendación de montaje doméstico económico o seguro. La potencia, consumo eléctrico y estabilidad pueden ser obstáculos más importantes que conseguir que el modelo arranque.